지역별 태양광 발전량 예측 및 운영 솔루션

문제 정의
태양광 발전은 효율이 약 12%로 수력(80 ~ 90%),화력(45 ~ 50%),원자력(30 ~ 40%)에 비해 낮고, 일사·일조·적운·적설 등 날씨에 크게 좌우되어 발전량이 일정하지 않습니다. 재생에너지 3020 정책으로 발전소가 급증하는 가운데, 안정적 운영과 전력 거래를 위해서는 지역별 발전량 예측이 필수적입니다.
이 프로젝트는 전국 17개 지역의 태양광 발전량을 예측하고, 패널 상태 진단를 제공하는 운영 솔루션을 목표로 했습니다.
시스템 구조
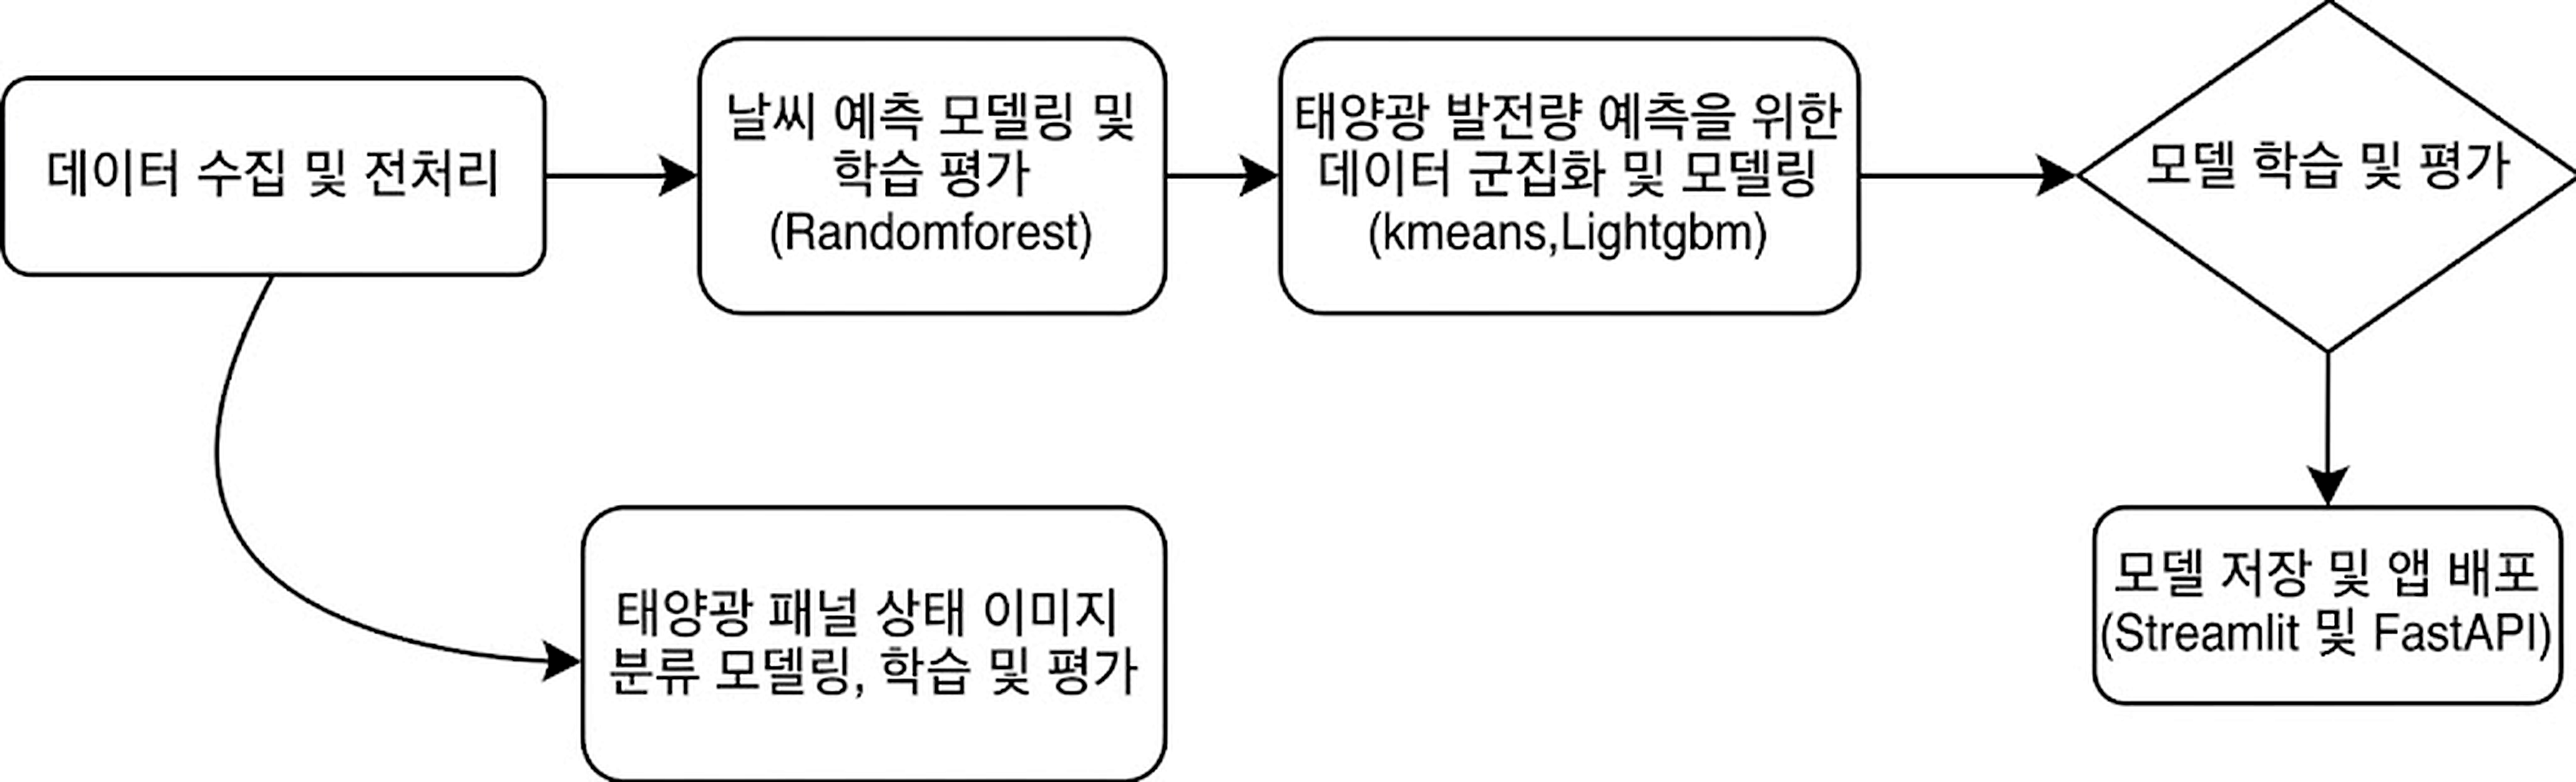
왜 날씨를 먼저 예측하고, 그 예측값으로 발전량을 예측했나? 태양광 발전량은 일사량·일조시간 같은 관측 날씨에 의해 결정됩니다. 그런데 우리가 알고 싶은 건 미래의 발전량이고, 미래의 관측 날씨는 아직 존재하지 않습니다. 따라서 ① 기상 예보로 미래의 관측 날씨를 먼저 예측 → ② 예측된 날씨로 미래 발전량을 예측하는 2단계 구조를 설계했습니다.
왜 패널 상태 분류까지 만들었나? 발전량을 아무리 정확히 예측해도, 현장의 패널이 먼지,새똥,손상 등으로 제대로 관리되지 않으면 실제 발전량은 예측을 따라가지 못합니다. 따라서 예측을 운영·관리 시스템의 일부로 완성하기 위해, 발전량이 예측보다 낮을 때 혹은 미리 패널 상태를 진단해 관리할 수 있도록 패널 상태 분류 모델을 함께 만들었습니다.
이 두 가지 이유로 아래 3단계 파이프라인을 설계했습니다.
- 날씨 예측 — 기상 예보 데이터로 미래의 관측 날씨(일사·일조 등)를 예측
- 발전량 예측 — 예측된 관측 날씨로 지역별 태양광 발전량을 예측
- 패널 상태 분류 (관리) — 발전량이 예측보다 낮을 때 패널 상태를 진단해 원인을 파악
1. 날씨 예측 모델
목표: 전날 17시에 발표되는 기상 예보를 입력으로, 다음날의 실제 관측 날씨(일사,일조,습도,지면온도,기온,풍속 등)를 예측합니다. 발전량 예측의 입력이 되는 단계라 정확도가 전체 파이프라인의 토대가 됩니다.
기상청 매칭 & 변수 선별. 발전소마다 위치가 다르므로, 설비용량으로 가중한 위·경도를 계산해 각 지역에서 가장 가까운 기상청을 매칭했습니다. 이후 발전량과 상관계수 절댓값 0.2 이상인 날씨 변수만 선별하고, 결측은 Random Forest 기반 반복 대치(Iterative Imputer)로, 전부 결측인 경우는 인접한 날짜 데이터로 보완했습니다.
핵심 — 일사·일조량이 없는 지역의 직접 계산 + 구름 가중치 파생변수. 일부 지역(울산,세종,경북 등)은 일사량 및 일조시간이 관측되지 않아, 발전량 예측의 가장 중요한 입력이 비어 있는 문제가 있었습니다. 이를 인접 지역 값으로 대체하면 정확도가 크게 떨어졌습니다. 그래서 물리적으로 직접 계산하는 방식을 설계했습니다.
위·경도 + 시간으로 이론적 일사량 계산: 태양의 고도 및 방위는 위경도와 시각으로 결정되므로, 이를 이용해 맑은 하늘 기준 이론적 일사량과 일조시간을 직접 산출했습니다.
구름 가림을 가중치로 반영: 실제로는 구름이 햇빛을 가리므로, 그날의 하늘 상태를 가중치로 곱해 보정했습니다. 예보의 하늘 상태 코드별로 가중치를 부여했습니다.
하늘 상태 매우 맑음 맑음 구름 조금 구름 많음 흐림 가중치 1.0 0.8 0.5 0.3 0.05 → 조정된 일사량 = 이론적 일사량 × 하늘 상태 가중치 로 파생변수를 생성해, 관측값이 없는 지역에서도 발전량 예측에 쓸 수 있는 입력을 확보했습니다.
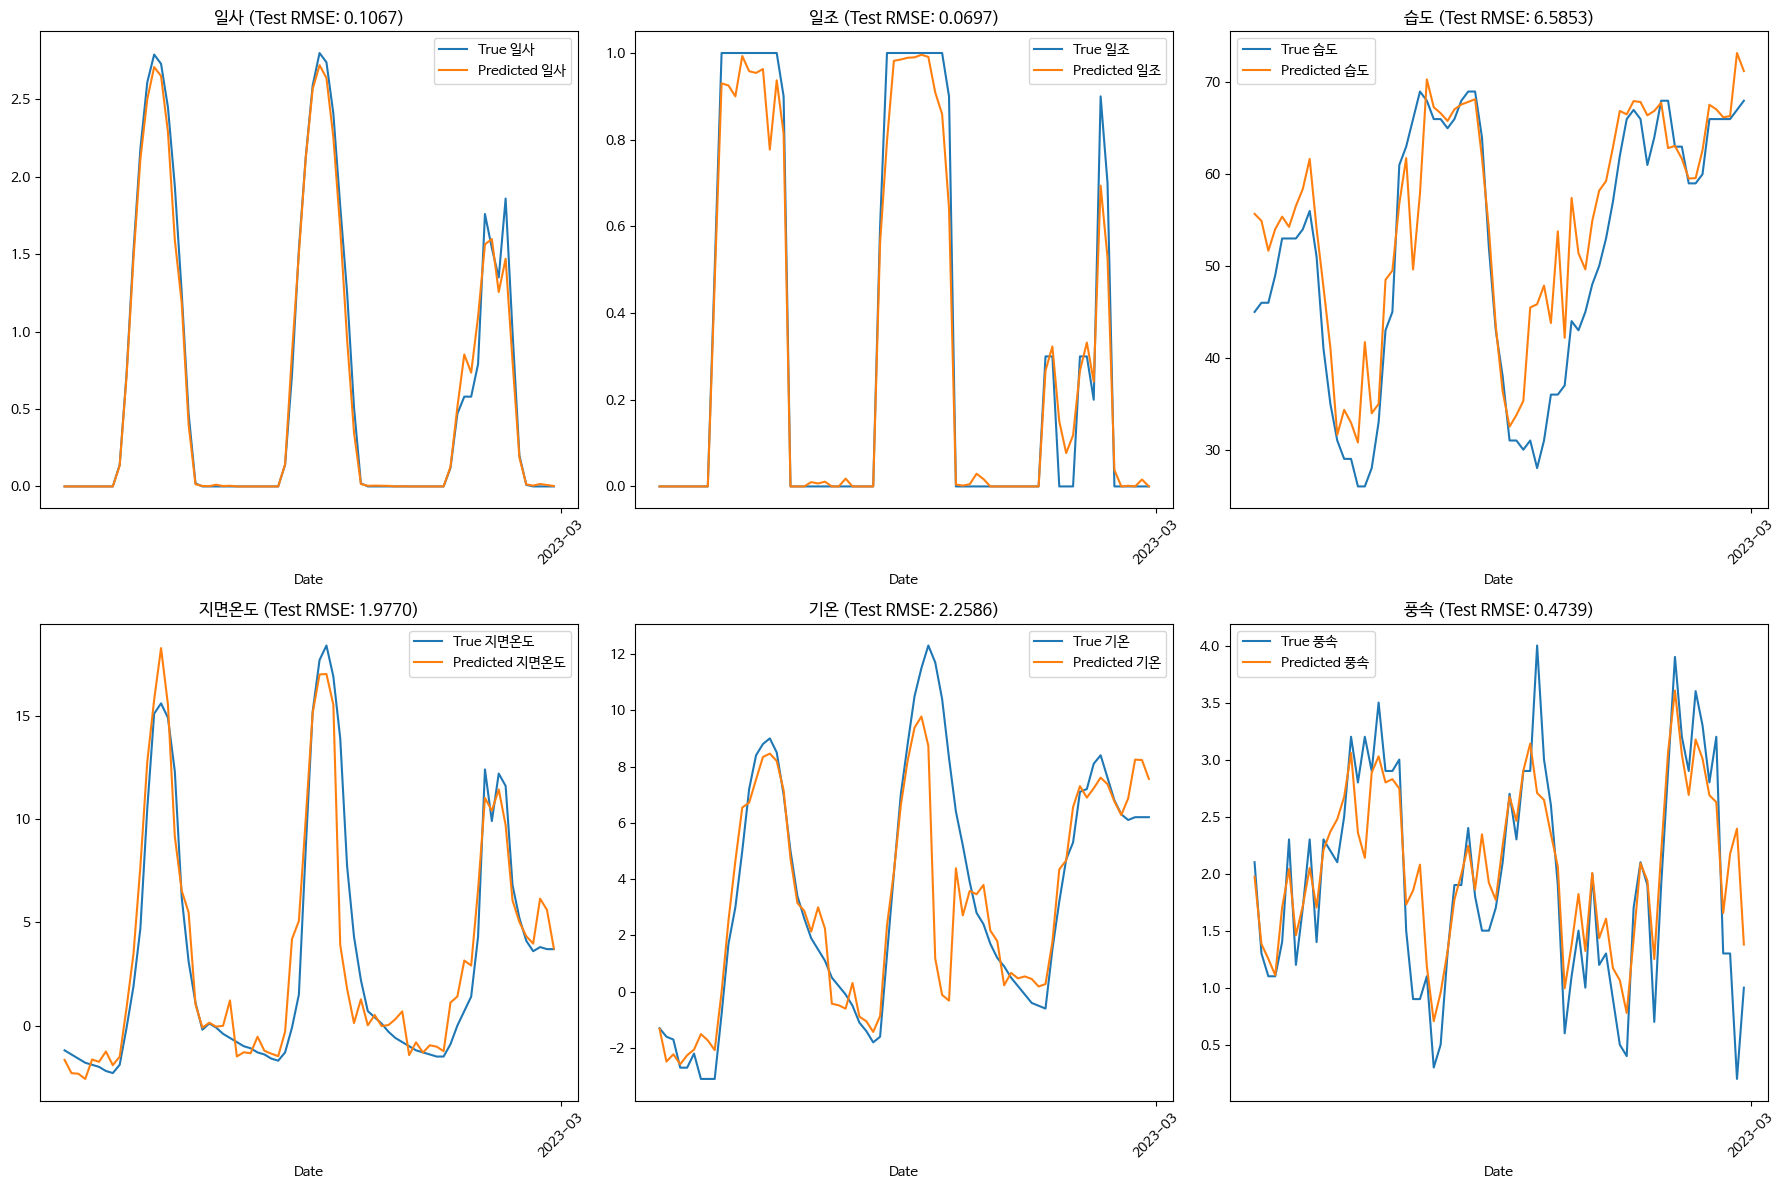
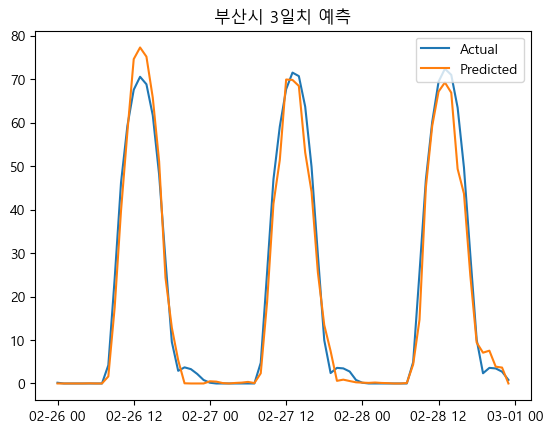
모델 선택. LSTM·LightGBM·XGBoost·Random Forest를 같은 데이터로 비교한 결과(서울 기준 RMSE), 기온,습도,일사량처럼 특성이 다른 변수들의 상호작용을 안정적으로 처리하는 Random Forest가 가장 우수해 최종 채택했습니다. 학습에 한 번도 쓰지 않은 3일치 데이터에서도 일사 RMSE 0.1, 일조 RMSE 0.06으로 안정적인 성능을 보였습니다.
2. 태양광 발전량 예측 모델
입력 설계. 1단계에서 예측한 관측 날씨에, 태양광이 시계열 특성을 갖는다는 점을 반영해 피처를 추가했습니다. 날짜 피처(연.월.일.요일)에 더해, 발전량이 전날의 발전량·날씨에 영향받는다는 사실을 담은 과거 발전량(lag)·이동평균 시계열 피처를 생성했습니다.
왜 군집화 후 군집별로 모델을 만들었나. 같은 전국 데이터라도 일사량·일조시간 수준에 따라 발전 패턴이 크게 달라집니다. 하나의 모델로 전 구간을 학습하면 평균적인 패턴에 묻혀 버리므로, 발전에 영향이 큰 일사량·일조시간을 기준으로 K-means 군집화(Elbow로 군집 수를 3개로 최적화)한 뒤 각 군집마다 별도의 LightGBM을 학습시켜, 발전 강도대별로 특화된 예측이 가능하도록 했습니다.
왜 LightGBM인가. 대규모 데이터에서도 학습이 빠르고, 결측 처리와 다양한 변수의 비선형 상호작용에 강하며, 과적합 방지에 장점이 있어 복잡한 시계열 특성을 가진 태양광 발전량 예측에 적합했습니다.
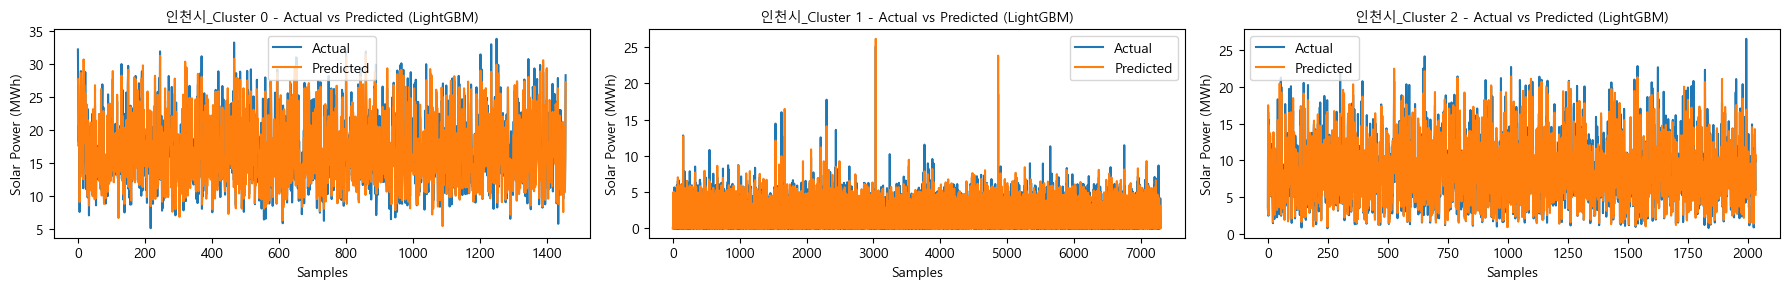
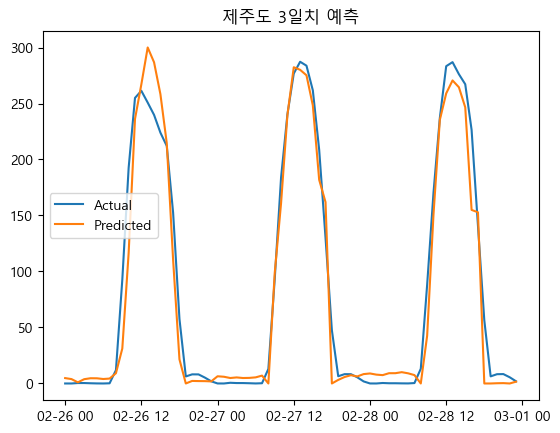
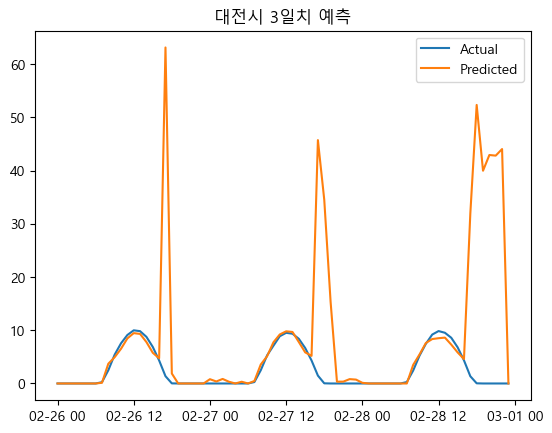
결과 — 데이터 품질에 따라 예측 성능이 갈렸다. 시계열 피처와 군집별 모델 적용으로 서울시 기준 RMSE 0.57 → 0.52, MAE 0.38 → 0.33 로 예측력이 약 10% 향상됐고, 강원도(RMSE 18.62 → 15.67, MAE 12.26 → 10.04) 등 다른 지역에서도 비슷한 개선을 확인했습니다. 다만 대전처럼 데이터 품질이 낮은(일사 및 일조량이 관측되지 않아 인접 지역 값으로 대체한) 지역에서는 모델이 충분히 학습하지 못해 예측 성능이 낮았습니다. 즉 같은 모델이라도 입력 데이터의 품질이 예측 정확도를 좌우했으며, 이 한계가 1단계에서 일사량을 직접 계산·보정한 이유와 직접 연결됩니다.
3. 태양광 패널 상태 분류
왜 만들었나. 발전량을 정확히 예측해도, 패널이 먼지,새똥,손상 등으로 관리되지 않으면 실제 발전량은 예측을 따라가지 못합니다. 그래서 “예측 발전량 vs 실제 발전량"의 괴리를 진단하는 관리 도구로, 패널 상태를 분류하는 모델을 만들었습니다.
모델. 패널 이미지를 DenseNet121로 6개 상태(정상,새똥,먼지,전기적 결함,물리적 손상,눈 덮임)로 분류했습니다. 적은 데이터에서도 잘 작동하는 구조라 선택했고, 데이터 증강으로 다양한 상황에 강건하도록 학습했습니다.
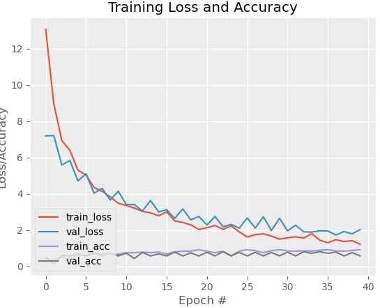
결과. 전체 정확도 75% → (정제 테스트셋) 85% 를 달성했으며, 눈 덮임(Snow-Covered) 클래스는 F1 0.93으로 특히 높은 성능을 보였습니다. 학습 곡선에서 Loss가 안정적으로 수렴해 과적합 없이 학습이 잘 이뤄졌습니다.
| 클래스 | P | R | F1 |
|---|---|---|---|
| Bird-drop | 0.68 | 0.85 | 0.76 |
| Clean | 0.72 | 0.74 | 0.73 |
| Dusty | 0.81 | 0.55 | 0.66 |
| Electrical-damage | 0.71 | 0.79 | 0.75 |
| Physical-Damage | 0.70 | 0.54 | 0.61 |
| Snow-Covered | 0.89 | 0.96 | 0.93 |
| Accuracy | 0.75 | ||
| Macro avg | 0.75 | 0.74 | 0.74 |
| Weighted avg | 0.75 | 0.75 | 0.74 |
4. 서비스화 & 배포
예측 모델을 실제 사용 가능한 웹 솔루션으로 구현했습니다.
- 백엔드: FastAPI + SQLAlchemy로 MySQL(AWS RDS)과 연동, 하루 한 번 배치 처리로 지역별 예측을 미리 계산·저장
- 프론트엔드: Streamlit으로 17개 지역 지도·발전량 그래프·기간별 예측 제공
- 수익 예측: 예상 발전량에 SMP(계통한계가격)·REC(신재생에너지공급인증서)를 곱해 예상 수익 = (SMP + REC) × 발전량 산출
- 배포: AWS EC2(백엔드+Streamlit 통합 호스팅), RDS(MySQL)
PM으로서의 기여
- 모델링 총괄: 날씨 예측 → 발전량 예측 → 패널 분류로 이어지는 전체 ML 파이프라인을 직접 설계·구현했습니다.
- 일정·역할 관리: 프론트엔드·백엔드·도메인 조사로 나뉜 5인 팀의 작업을 조율하고, 모델·서비스·배포가 한 흐름으로 통합되도록 관리했습니다.
- 확장 비전: IoT·디지털 트윈과 결합한 AIoT 생태계로의 확장 방향을 제시했습니다.
