LG Aimers 6기: 난임 시술 임신 성공률 예측

문제 정의
난임 환자의 IVF 시술 데이터를 바탕으로 임신 성공을 예측하는 과제입니다. 정밀한 예측은 의료진의 임상 의사결정과 환자 상담을 보조할 수 있습니다.
예선과 본선의 예측 대상(target)과 평가 방식이 달라, 이에 맞춰 모델링 전략을 완전히 다르게 가져갔습니다.
| 예선 | 본선 | |
|---|---|---|
| 예측 대상 | 임신 성공 여부 (0 또는 1) | 임신 성공 확률 (0~1 연속값) |
| 문제 유형 | 이진 분류 | 확률 회귀 |
| 평가 지표 | ROC-AUC | Weighted Brier + F1 혼합 Score |
| 핵심 전략 | CatBoost + AutoGluon 앙상블 | 가중치 손실 설계 + Stacking |
공통 — 데이터 전처리 & 파생변수
두 라운드 모두 의미 있는 파생변수 설계에 집중했습니다.
- 문자열 → 수치 변환:
"0회","1-5회",">20","6회 이상"같은 범위형 문자열을 중앙값 추정 또는 기준값+1 방식으로 수치화했습니다. - 결측치 처리: NaN을 대체하고 결측 존재 여부 플래그를 추가했습니다.
- 비율·상호작용 변수: 단순 수치 대신 의미 있는 파생변수를 생성했습니다.
- 배아 관련: 배아 이식 비율, ICSI(미세주입) 배아 비율, 배아 저장 비율, 배아 품질 지표
- 난자 관련: 난자 수정시도 비율, 난자 배아 생성 성공률, 신선/해동 난자 여부
- 시술·연령 관련: 이전 시술 총 횟수, 시술 경험 점수, 고위험 연령군, 연령 가중치, 이식 후 적정기간
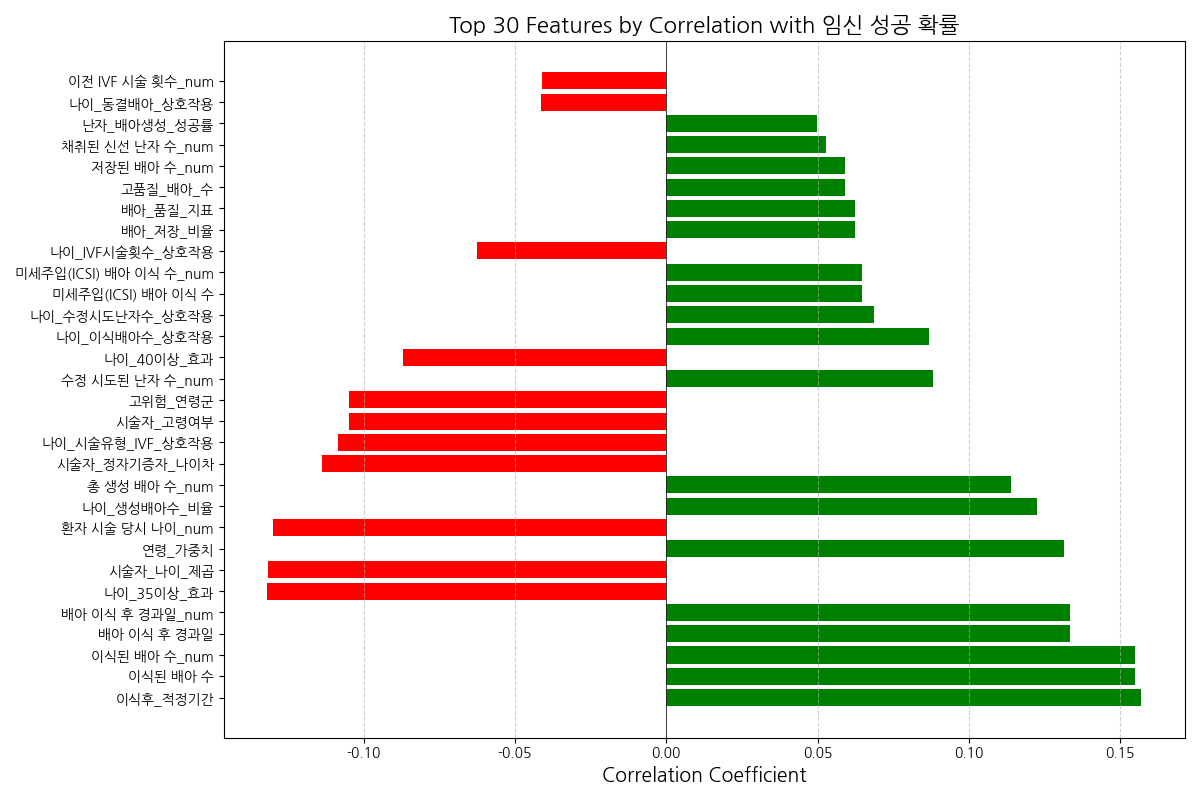
상관관계 분석으로 임신 성공에 유의미한 핵심 변수를 선별했습니다.
예선 — 임신 성공 여부 (이진 분류)
예선은 임신 성공을 0/1 이진 분류로 예측하고 ROC-AUC로 평가했습니다.
- CatBoost + Optuna: 범주형 변수 처리에 강한 CatBoost를 사용하고, Optuna로 8개 하이퍼파라미터를 Stratified 5-Fold 교차검증 기반으로 튜닝했습니다.
- AutoGluon: TabularPredictor로 다양한 모델을 자동 탐색(HPO)해 예측 확률을 얻었습니다.
- Weighted mean 앙상블: 두 모델의 예측을 가중평균해 최종 확률을 산출했습니다.
→ 단일 모델 대비 앙상블로 점수 0.70에서 0.74로 향상, 본선에 진출했습니다.
본선 — 임신 성공 확률 (회귀)
본선은 임신 성공을 0~1 사이 연속 확률로 예측해야 했고, 평가 지표 자체가 바뀌었습니다. 단순 정밀도가 아니라 확률 정확도(Weighted Brier)와 이진 분류 성능(F1)을 절반씩 섞은 점수였습니다.
$$\text{Score} = 0.5 \times \left(1 - \frac{\sum w_i (y_i - \hat{y}_i)^2}{\sum w_i}\right) + 0.5 \times \frac{2TP}{2TP + FP + FN}$$이 지표에 맞춰 두 가지 전략을 새로 설계했습니다.
1. 가중치 기반 손실 설계
평가식의 가중치 $w_i = 1 + 4y_i + (0.5 - y_i)^2$ 를 학습 손실에 반영해, 임상적으로 중요한 임신 성공(희귀 클래스) 케이스에 더 민감하게 반응하도록 유도했습니다. 예측값은 확률로 출력 가능하도록 Calibration 친화적인 모델을 사용했습니다.
2. CatBoost + LightGBM Stacking
- Stage 1: CatBoost로 예측값과 잔차(residual)를 계산
- Stage 2: CatBoost 출력값 + 잔차를 LightGBM의 입력으로 활용
CatBoost의 범주형 처리·일반화 능력에 더해, LightGBM이 예측 오류 영역을 보완하도록 했습니다. 마지막으로 Stacking 예측을 CatBoost 단독 예측으로 보정하는 Ensemble 비율을 실험적으로 탐색해 최적 비율(n=3) 을 도출했습니다.
$$\hat{y}_{final} = \frac{n \cdot \hat{y}_{stacking} + \hat{y}_{catboost}}{n + 1}, \quad n = 3$$→ 본선 점수 0.64에서 0.66으로 개선, 최종 7위를 달성했습니다.
핵심 요약
- 평가 방식에 맞춘 모델 설계: 예선(이진 분류·ROC-AUC)과 본선(확률 회귀·가중 혼합 Score)의 차이를 정확히 반영해 전략을 분리했습니다.
- 본선의 핵심 기여: 평가식의 가중치를 손실 함수에 직접 반영하고, CatBoost+LightGBM Stacking으로 예측 성능과 안정성을 동시에 확보했습니다.
- 해석 가능성: 의학적 맥락에 맞춘 비율·상호작용 파생변수로 해석 가능한 예측 구조를 설계했습니다.
