시계열 센서 데이터 기반 자동차 엔진 이상 탐지

문제 정의
엔진은 자동차 동력의 심장과도 같아서, 이상이 생기면 곧바로 안전 문제로 이어집니다. 실제로 최근 5년간 접수된 자동차 결함 신고에서 엔진 관련 문제가 가장 큰 비중을 차지했습니다. 그래서 엔진에 부착된 센서를 실시간으로 들여다보며 이상 징후를 미리 잡아내는 일이 점점 더 중요해지고 있습니다.
저희는 이 문제를 이진 분류로 풀기로 했습니다. 한 시점에서 측정된 센서 값들을 보고 그 순간 엔진이 정상인지 아닌지를 가려내는 것입니다.
- 입력: 특정 시점 $t$ 에 측정된 500개 센서 값
- 타깃: 그 시점의 엔진 상태 — 정상(1) / 이상(−1)
- 목표: 500개 센서만으로 현재 엔진 이상 여부를 정확히 판별
데이터 탐색
어떤 모델을 쓸지 정하기 전에, 데이터가 시간적으로, 또 센서 간 공간적으로 어떤 구조를 갖는지부터 살펴봤습니다.
① 시간적으로는 거의 무관했습니다. ACF/PACF를 보니 lag 1 이후로는 시간적 상관이 사라져, 타깃이 사실상 백색잡음(white noise)처럼 움직였습니다. 이는 과거 시점을 길게 기억하는 RNN 계열의 장점이 여기서는 작동하지 않는다는 것입니다.
② 반면 센서끼리는 강하게 얽혀 있었습니다. 센서 사이에는 뚜렷한 선형 상관 클러스터가 보였고, 특히 번호가 가까운 센서일수록 상관이 강했습니다(예: 10–13번 구간은 음의 상관, 1–3번 구간은 양의 상관). 즉 이상을 가르는 단서는 시간이 아니라 가까이 붙은 센서들이 함께 만드는 국소 패턴에 있었습니다. PCA로 약 66개 주성분까지 줄여도 봤지만 성능이 오히려 떨어져서, 500개 센서를 그대로 쓰기로 했습니다.
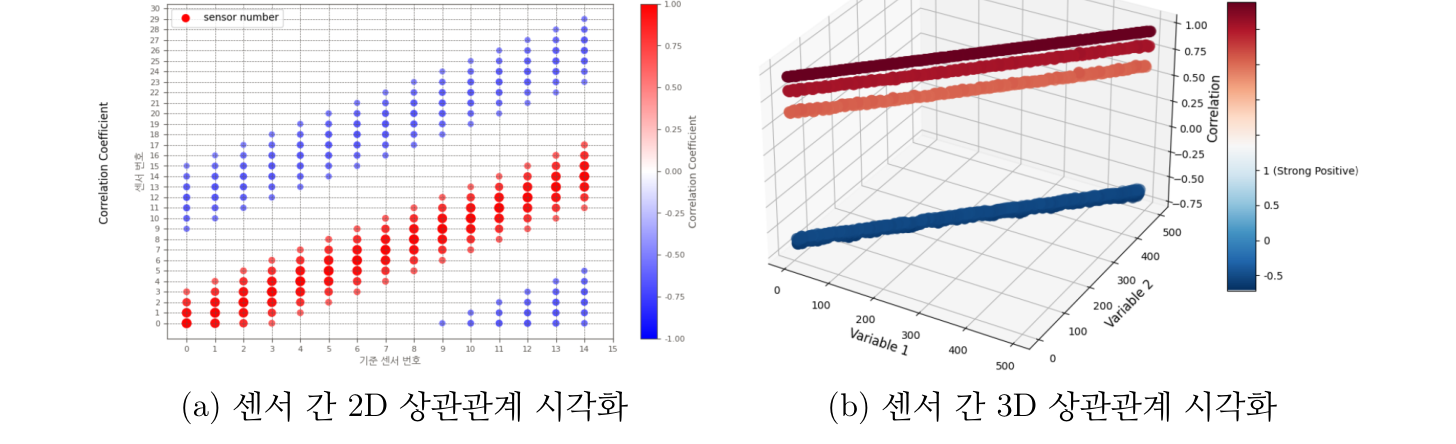
→ 이 두 가지를 종합해 “시간보다 인접 센서의 국소 패턴이 더 중요하다” 는 가설을 세웠고, 그런 패턴을 잡아내는 데 강한 1D-CNN을 가장 유력한 후보로 두었습니다.
데이터 전처리
- 시계열 누수 막기: 클래스별 80% 지점 중 더 뒤쪽 시점을 공통 기준으로 잡아 나눴습니다. 이렇게 해야 미래 데이터가 학습에 새어드는 시간적 누수(leakage) 를 막을 수 있습니다.
- 클래스 비율 유지: 정상/이상 비율을 그대로 유지하며 나눠 한쪽으로 치우치지 않게 했습니다.
- 정규화: Standard와 Min-Max Scaler를 비교해, 센서마다 다른 단위,범위를 같은 스케일로 맞췄습니다.
후보 모델 & 최적화
접근 방식이 서로 다른 세 모델을 같은 데이터 위에서 나란히 비교해봤습니다.
| 관점 | 모델 | 설계 의도 |
|---|---|---|
| 트리 기반 | XGBoost | 센서별 중요도 기반 분류 |
| 순환 신경망 | LSTM | 게이트로 시간 의존성 학습 |
| 합성곱 신경망 | 1D-CNN | 인접 센서의 국소 패턴 추출 |
XGBoost. grid search로 하이퍼파라미터를 맞춰봤지만, Train Loss는 떨어지는데 Validation Loss는 제자리인 전형적인 과적합 양상을 보였습니다. AUC도 0.75에 머물렀습니다.
LSTM. 정규화 방식과 유닛 수를 바꿔가며 세 번 돌려보았고, 그중 유닛을 256개로 키운 설정이 정확도 92.88%로 가장 좋았습니다. AUC 0.93으로 성능은 높았지만 과적합 기미가 조금 있었고, 무엇보다 학습에 1시간이 넘게 걸렸습니다.
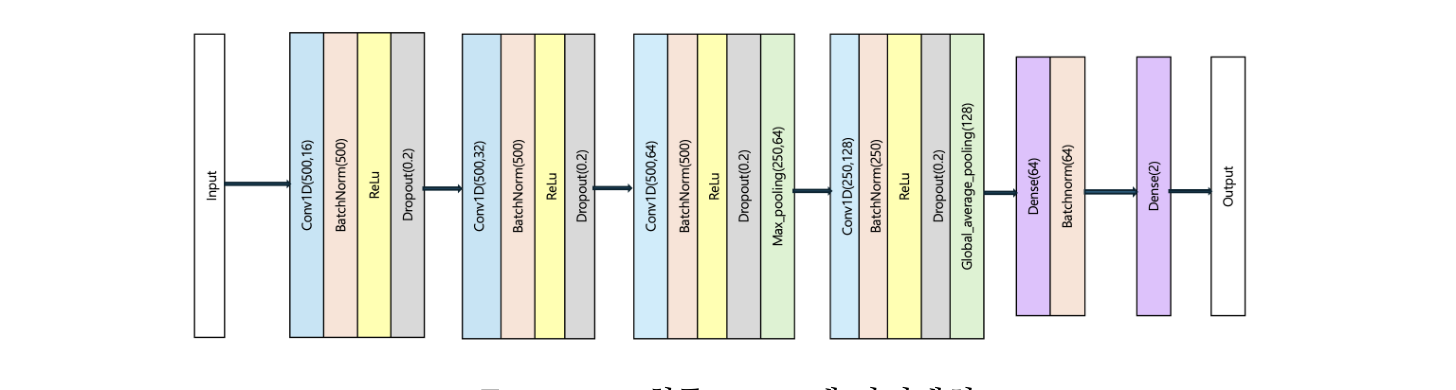
1D-CNN. 데이터 탐색에서 본 “좌우 15개 안팎의 센서가 강하게 얽힌다"는 특징을 그대로 설계에 반영했습니다. 첫 레이어 커널을 30으로 넓게 잡아 큰 패턴부터 보고, 이후 15 → 7 → 3 으로 좁혀가며 국소 패턴을 단계적으로 잡도록 했습니다. 각 Conv 블록에는 BatchNorm과 Dropout(0.2)을 넣어 과적합을 눌렀습니다.
모델링 결과
| 모델 | Test Accuracy | Test Loss | AUC | Confusion (TP·TN·FP·FN) |
|---|---|---|---|---|
| XGBoost | 74.92% | 0.5521 | 0.75 | 470 · 519 · 162 · 169 |
| LSTM | 92.88% | 0.2973 | 0.93 | 567 · 659 · 22 · 72 |
| 1D-CNN | 94.69% | 0.1338 | 0.95 | 608 · 643 · 38 · 31 |
결과적으로 1D-CNN이 정확도·안정성·속도 어느 쪽으로 봐도 가장 좋았습니다. Train과 Validation Loss가 나란히 수렴해 과적합이 없었고, 학습 시간도 약 10분으로 LSTM(1시간+)의 6분의 1 수준이었습니다. 데이터 탐색에서 세운 “시간보다 국소 공간 패턴이 중요하다"는 가설이 성능으로 확인되었습니다.
XAI — 모델은 무엇을 보고 판단했나
정확도가 높다고 해서 모델을 곧바로 믿을 수는 없습니다. 따라서 Grad-CAM과 SHAP로 “CNN이 대체 어디를 보고 이상이라 판단했는지"를 들여다봤습니다.
- Grad-CAM: 이상일 때 센서 활성화 값이 약 0.25, 정상일 때 약 0.12로 갈렸습니다. 모델이 이상이라고 볼 때 센서 신호를 훨씬 또렷하게 잡아낸다는 뜻입니다.
- SHAP: 두 방법 모두에서 번호가 서로 가까운 센서들(Grad-CAM은 472·428, SHAP은 471·429)이 핵심으로 꼽혔습니다.
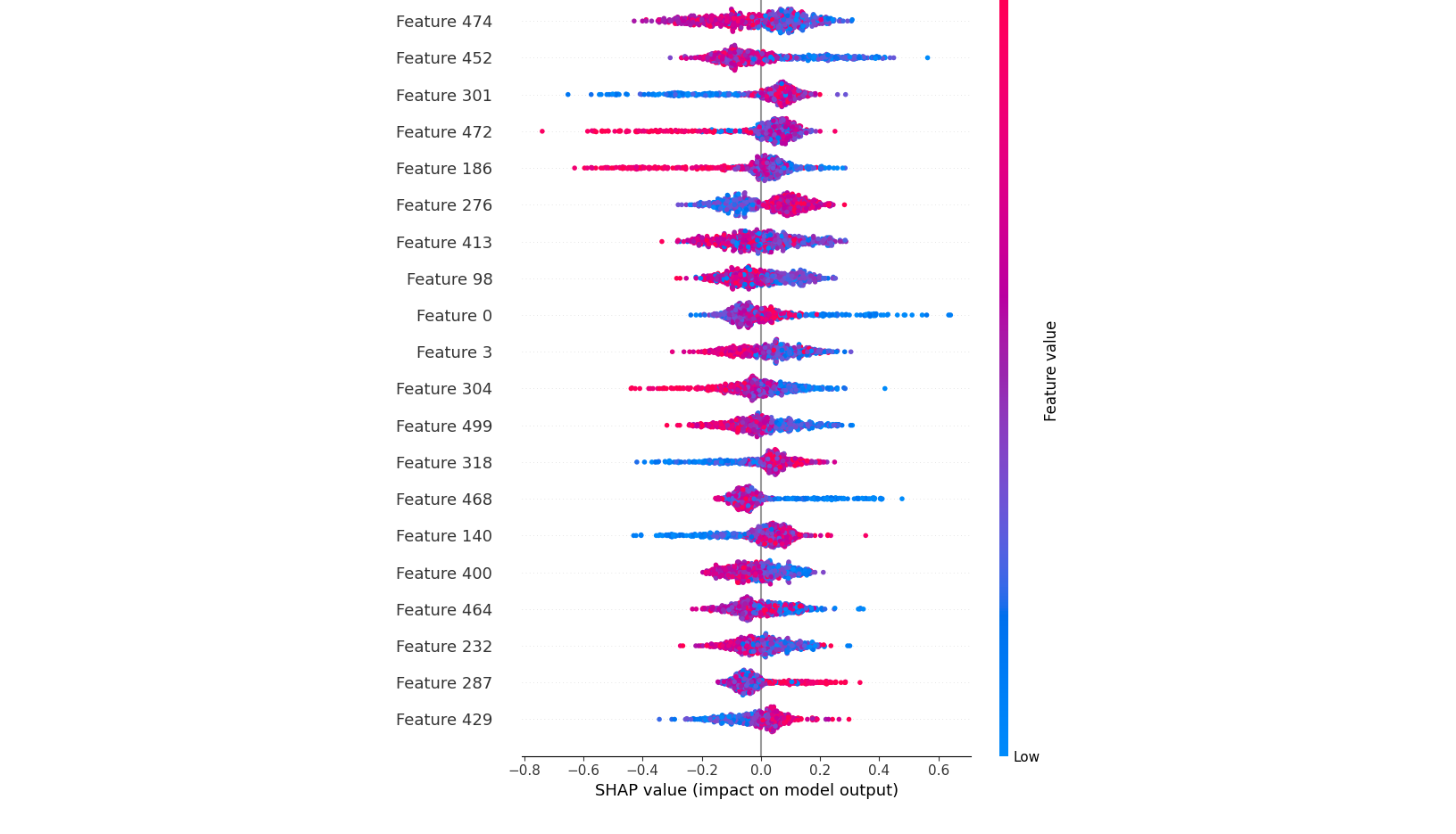
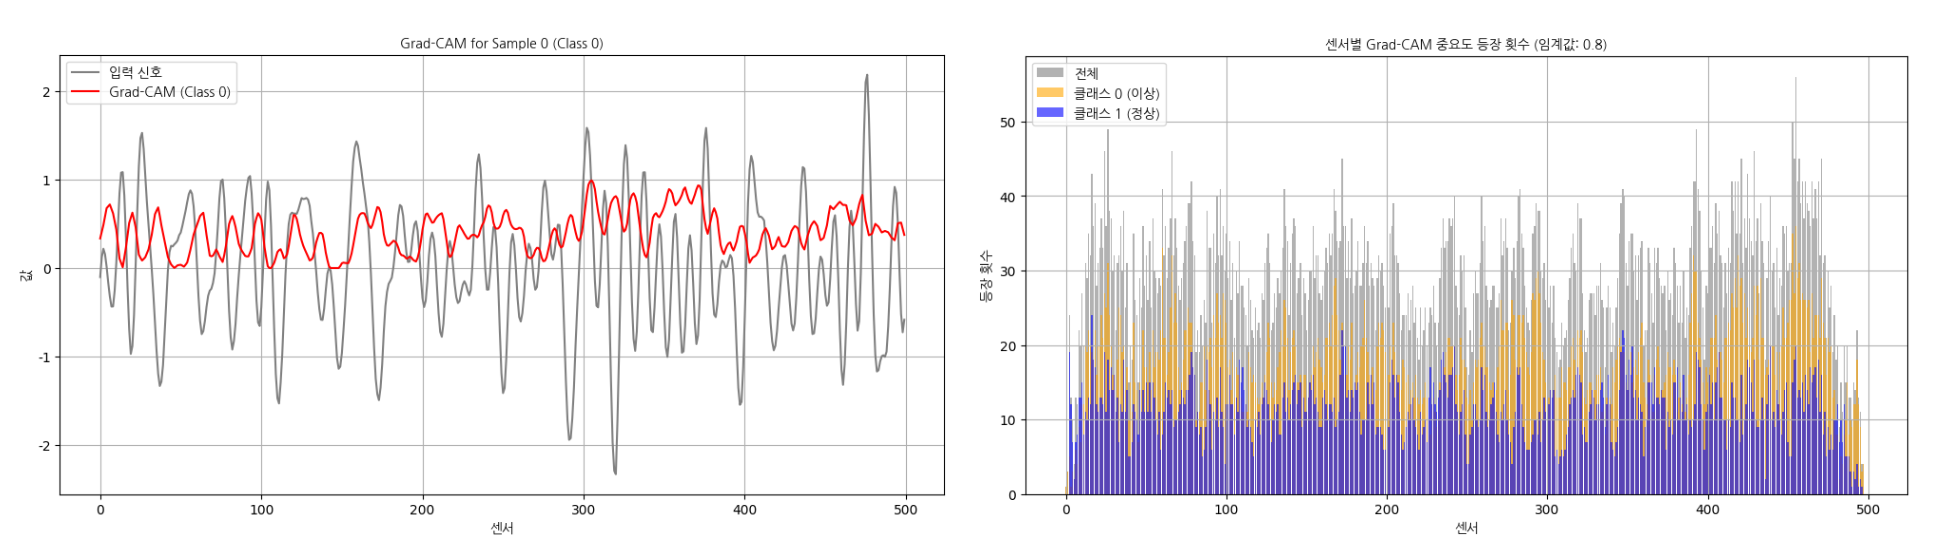
→ 두 해석 결과가 상당히 겹쳤고, 모두 인접 센서의 선형 패턴을 가리켰습니다. 처음 EDA에서 세운 가설을 모델이 실제로 그렇게 작동하고 있다는 것을 확인할 수 있었습니다.
핵심 요약
- 데이터를 보고 모델을 골랐다: “시간 상관은 약하고 인접 센서의 공간 상관이 강하다"는 EDA 결과를 근거로 1D-CNN을 택했고, 성능이 그 판단을 뒷받침했습니다.
- 세 모델을 비교했다: XGBoost(0.75) < LSTM(0.93) < 1D-CNN(0.95, 정확도 94.69%) — 성능도 속도도 앞선 CNN을 최종 모델로 채택했습니다.
- 왜 맞췄는지까지 확인했다: Grad-CAM과 SHAP가 같은 결론을 내, 인접 센서의 선형 패턴이 이상 판별의 핵심이라는 점을 분명히 했습니다.
