다이캐스팅 공정데이터 이상 탐지
2025.12.10· ,,·
4 min read
Sieun Kim
박지훈
박지민
개요
다이캐스팅 공정의 시계열 패턴을 기반으로 불량을 예측하고, SHAP·CCF로 불량의 주요 원인을 해석한 제조데이터 분석 프로젝트입니다.
대회
제4회 K-인공지능 제조데이터 분석 경진대회 (KAMP, 2024)
기간
2024.10~2024.11(약 2주)
데이터
다이캐스팅 공정 시계열 2,852,465 cells (92,015 rows × 31 columns)
기술 스택
Python · pandas · NumPy · scikit-learn · XGBoost · SHAP · Matplotlib
성과
Accuracy 0.9970 · Recall 0.9501 · Precision 0.9794 · F1 0.9646
문제 정의
다이캐스팅은 금형(Die)에 녹인 금속을 고압으로 주입해 제품을 만드는 주조 공법으로, 압력·속도·시간·온도 4대 조건을 일정하게 유지하는 것이 중요합니다.
- 주요 변수의 시계열적 특성이 크게 변동하거나 일정 패턴을 벗어날 때 불량이 빈번하게 발생합니다.
- 현장 관리자는 변수의 실시간 변동은 볼 수 있지만, 그 패턴이 불량에 어떤 영향을 미치는지 구체적으로 파악하기 어렵습니다.
- 특히 중소기업은 설비 운영이 작업자 경험에 의존해 체계적 관리가 어렵습니다.
→ 시계열 패턴이 불량에 기여하는 정도를 정량적으로 설명하는 모델이 필요합니다.
접근 방법
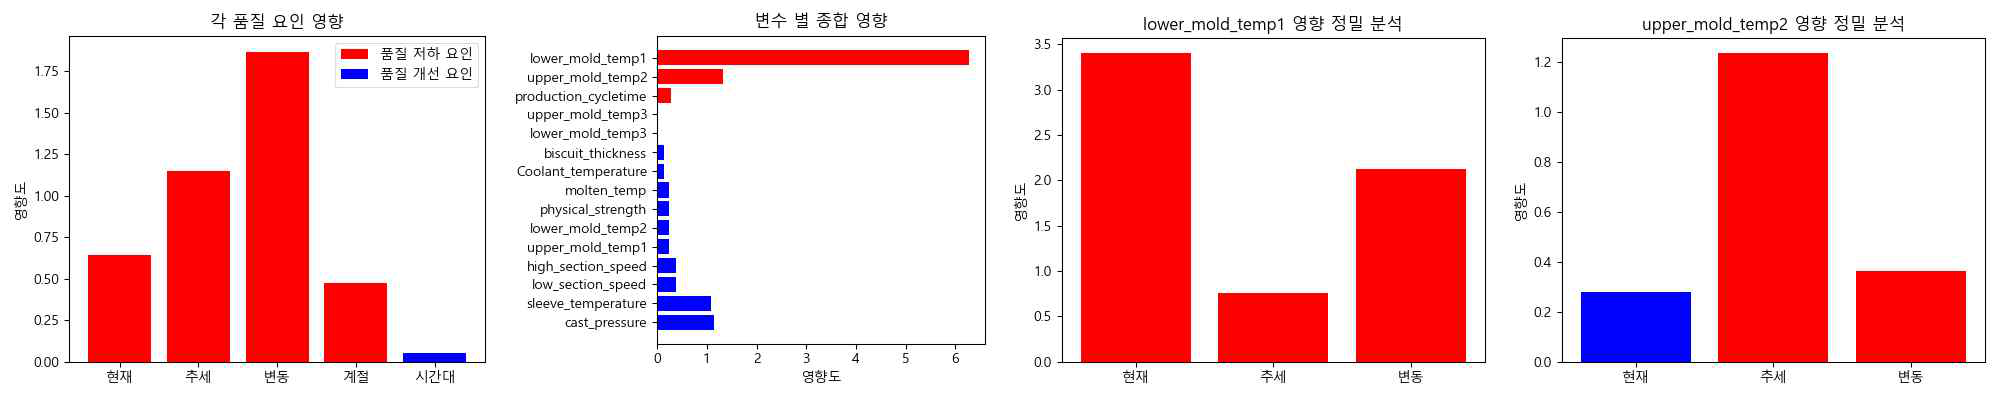
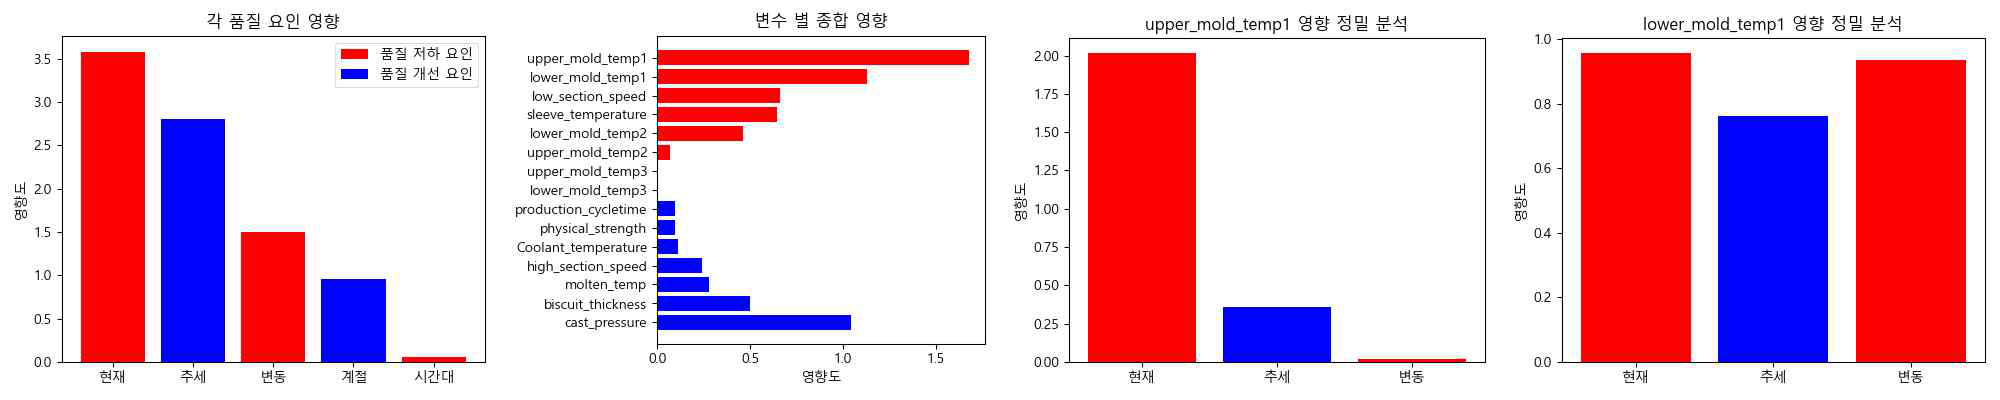
불량(수율 영향인자)을 다섯 가지 관점으로 나누어 시계열 특성을 반영했습니다.
- 현재 상태 — 변수의 현재 값이 불량에 미치는 즉각적 영향
- 변동성 — 일정 기간의 변동성이 품질에 미치는 영향
- 변화 추세 — 이동평균 기반 장기적 변화 방향의 누적 영향
- 계절성 — 연중 시기에 따른 품질 변화
- 시간대 — 하루 중 밤/낮 변화
데이터 전처리 & 파생변수
- 롤링 윈도우(window=5) 로 각 공정 변수의 이동평균과 이동 변동계수를 생성했습니다. 변수 특성에 따라 금형코드·가열로 단위로 그룹화하여 계산했습니다.
- 시계열 특성을 위해 연중 며칠째인지(계절성)와 하루 중 시간대의 주기성을 나타내는 파생변수를 추가했습니다.
- 유효 범위 외 이상치는 결측 처리 후 평균으로 대체하여 일관성을 유지했고, 데이터 완전성·정확성·무결성 품질지수 100을 달성했습니다.
- T-검정 결과 모든 파생변수의 p-value < 0.05 로, 생성 변수가 품질에 유의한 영향을 미침을 확인했습니다.
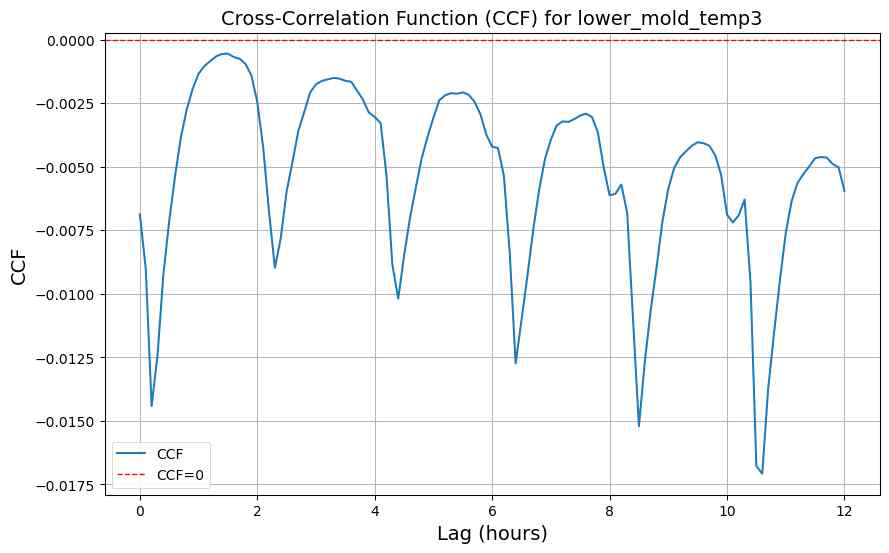
CCF 분석 — 시차를 고려한 영향력 검증
교차상관함수(Cross-Correlation Function)로 각 공정 변수가 지연 시간(lag) 에 따라 불량 판정에 미치는 상관관계를 분석했습니다.
예측 모델 — XGBoost
금형코드·가열로 같은 범주형 변수와 비선형 상호작용이 많은 제조데이터 특성에 강점이 있는 XGBoost를 채택했습니다.
- 클래스 불균형 처리: 불량 비율이 낮은 문제를 보정하기 위해 불량 클래스에 더 높은 가중치를 부여했습니다.
- 데이터 분할: 클래스 비율을 유지하며 학습·검증·테스트로 분할했습니다.
| 모델 | Accuracy | Recall | Precision | F1 Score |
|---|---|---|---|---|
| Random Forest | 0.9965 | 0.9377 | 0.9817 | 0.9592 |
| AdaBoost | 0.9936 | 0.8928 | 0.9572 | 0.9239 |
| Decision Tree | 0.9957 | 0.9327 | 0.9664 | 0.9492 |
| XGBoost | 0.9970 | 0.9501 | 0.9794 | 0.9646 |
XAI — SHAP 기반 불량 원인 해석
SHAP(Shapley Additive Explanations)로 각 변수가 불량 발생에 기여하는 정도를 정량화했습니다. 각 변수를 현재상태/변화추세/변동성 특성으로 나누어 합산했습니다.
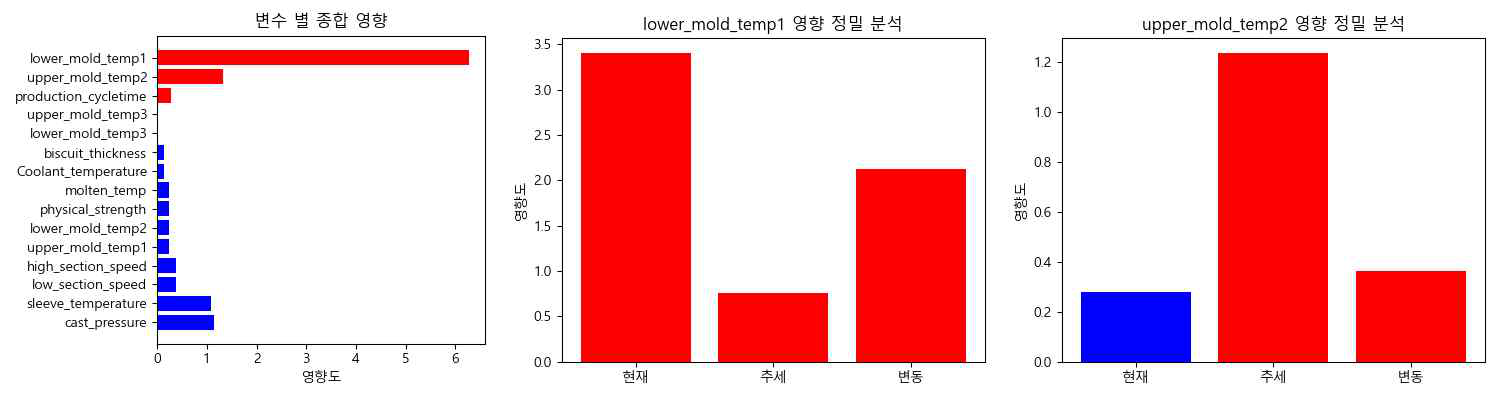
개별 생산품 진단 예시
기대 효과
- 체계적 공정관리: 제품 생산 시점마다 공정 변수의 현재 상태·변동성을 평가해 품질 저하 요인을 즉시 조정할 수 있습니다.
- 비용 절감: 가벼운 트리 기반 모델로 고성능 컴퓨팅 자원 없이 수 분 내 분석 및 해석이 가능합니다.
- 확장성: 온도 및 습도를 다루는 다른 제조 공정(예: 레진 도포, 경화)으로도 확장 가능하며, 불균형한 범주형 데이터에서 F1 0.980의 높은 예측력을 보였습니다.
